„Ein Chatbot, der unsere eigenen Dokumente kennt" steht inzwischen auf vielen Wunschlisten. Technisch ist das kein Hexenwerk mehr – die Enttäuschung kommt trotzdem oft, weil im Hintergrund etwas anderes passiert als erwartet. Dieser Artikel erklärt, was hinter dem Verfahren steckt, unter welchen Bedingungen es trägt und wie sich die Datenschutzfrage sauber beantworten lässt.
1. Was RAG wirklich macht
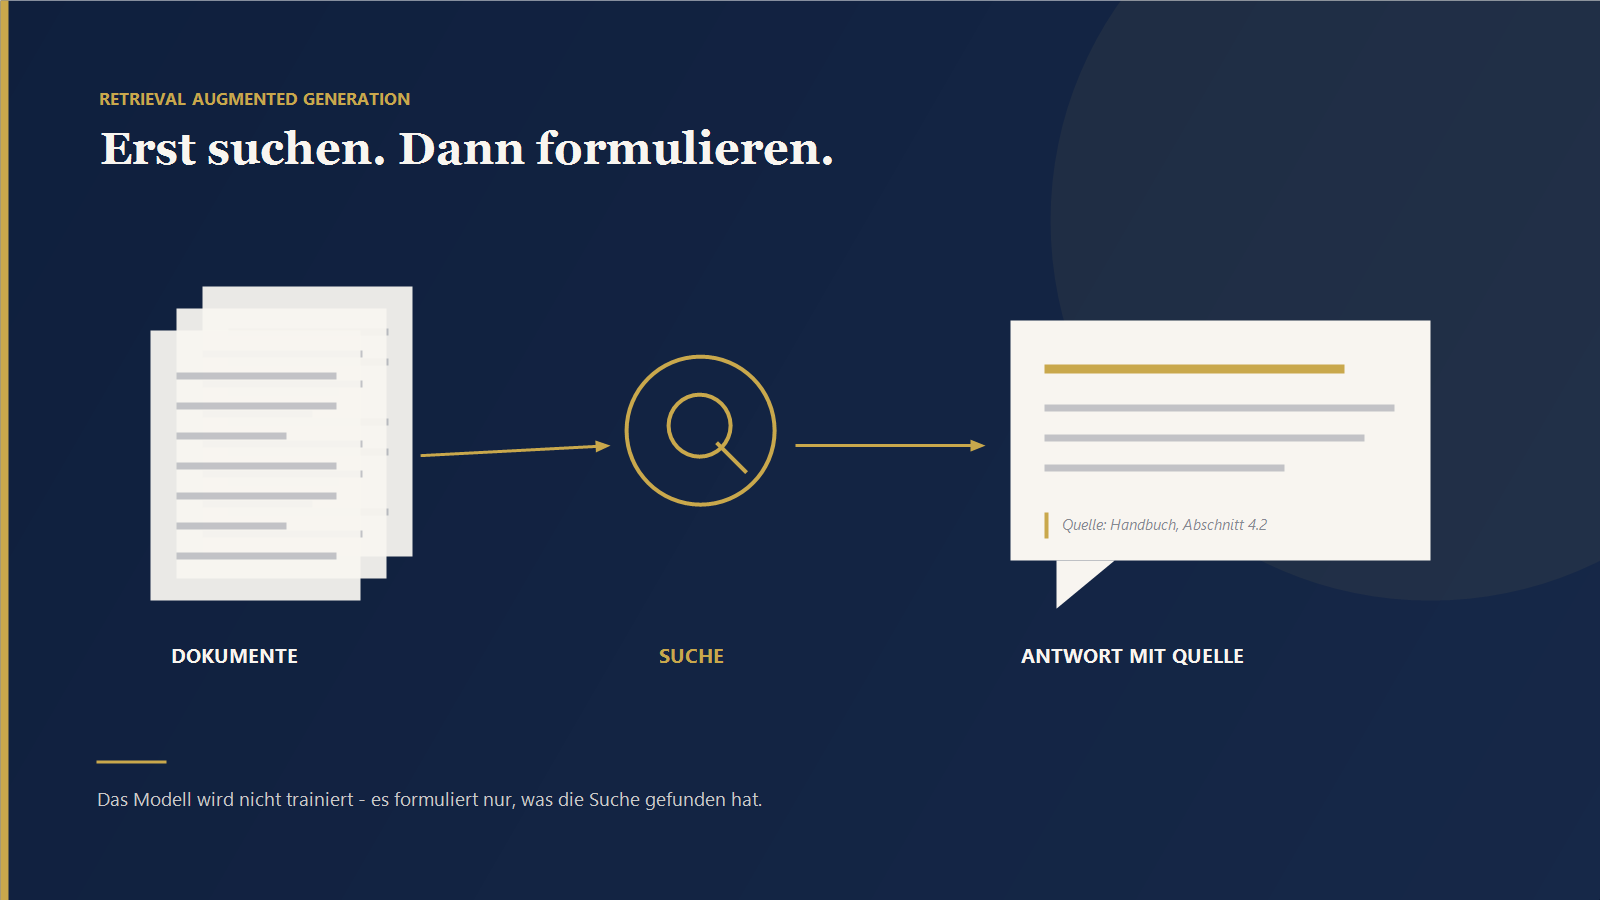
RAG steht für Retrieval Augmented Generation, also etwa: erst suchen, dann formulieren. Wichtig ist der erste Teil. Das Sprachmodell lernt Ihre Dokumente nicht – es wird nicht trainiert und speichert nichts. Stattdessen läuft bei jeder Frage eine Suche über Ihre Dokumente, und nur die gefundenen Abschnitte gehen zusammen mit der Frage an das Modell. Dessen Aufgabe ist ausschließlich, aus diesen Abschnitten eine lesbare Antwort zu formulieren.
Die Qualität einer RAG-Lösung entscheidet sich fast vollständig in der Suche, nicht im Sprachmodell. Ein größeres Modell repariert keine schlechte Wissensbasis – es formuliert die falsche Antwort nur eleganter.
Daraus folgt der wichtigste praktische Punkt: Ein solches System ist immer nur so gut wie die Dokumente, die es durchsuchen darf. Wer drei Versionen derselben Arbeitsanweisung einspeist, bekommt widersprüchliche Antworten – und zwar völlig zu Recht.
2. Wann es sich lohnt – und wann nicht
Der Nutzen entsteht dort, wo Wissen zwar vorhanden, aber schwer auffindbar ist, und wo dieselben Fragen immer wieder gestellt werden. Fehlt eine dieser Bedingungen, ist der Aufwand selten gerechtfertigt.
Lohnt sich
- Viele Dokumente, verteilt über Laufwerke, Wiki und Mailpostfächer
- Wiederkehrende Fragen an wenige Wissensträger
- Neue Mitarbeiter brauchen lange, bis sie sich zurechtfinden
- Der Bestand wird gepflegt und hat erkennbare Versionsstände
- Support oder Innendienst beantwortet Fragen, die schon dokumentiert sind
Lohnt sich nicht
- Das Wissen steckt in Köpfen, nicht in Dokumenten
- Der Bestand ist veraltet und niemand ist zuständig
- Antworten müssen rechtsverbindlich sein – dann braucht es einen Menschen
- Es geht um Rechnen und Auswerten – dafür ist eine Abfrage das richtige Werkzeug
- Zwanzig Dokumente, die alle kennen – da genügt eine gute Suche
3. Die DSGVO-Frage
Die Sorge ist berechtigt: Wenn Auszüge aus internen Dokumenten an ein Sprachmodell gehen, verlassen Daten das Haus. Die Frage ist also nicht ob, sondern wohin. In der Praxis gibt es drei Betriebsmodelle, und sie unterscheiden sich deutlich in Aufwand und Antwortqualität:
- Modell eines großen Anbieters mit Auftragsverarbeitungsvertrag. Beste Antwortqualität, geringster Aufwand. Voraussetzung sind ein AVV, die Verarbeitung in der EU und die vertragliche Zusicherung, dass Eingaben nicht zum Training verwendet werden. Für interne Handbücher, Richtlinien und technische Dokumentation ist das in aller Regel tragfähig.
- Europäischer Anbieter. Gleiches Prinzip, kürzerer Rechtsweg, etwas geringere Auswahl an Modellen.
- Modell im eigenen Haus. Nichts verlässt das Netz. Der Preis dafür sind Hardware, Betrieb und eine spürbar schwächere Sprachqualität. Sinnvoll, wenn personenbezogene oder streng vertrauliche Inhalte im Spiel sind.
Der praktische Hebel liegt vor der Modellwahl: Was gar nicht erst in die Wissensbasis aufgenommen wird, muss auch nicht geschützt werden. Personalakten und Kundendaten haben in einer Wissensdatenbank für Arbeitsanweisungen nichts verloren.
Unabhängig vom Modell gilt: Die Zugriffsrechte Ihrer Dokumente müssen sich im System abbilden. Ein Chatbot, der jedem alles beantwortet, ist ein Datenschutzproblem – auch wenn er vollständig im eigenen Rechenzentrum läuft.
4. Der Ablauf in fünf Schritten
Ausgangspunkt sind die zwanzig bis dreißig Fragen, die im Alltag wirklich gestellt werden. Sie entscheiden, welche Dokumente überhaupt in die Wissensbasis gehören – und sie sind später der Maßstab, an dem sich das System messen lassen muss.
Veraltete Fassungen, Duplikate und Entwürfe fliegen raus. Ein System, das drei Versionen derselben Richtlinie kennt, antwortet zwangsläufig mal so und mal so – und verliert damit sofort das Vertrauen der Nutzer.
Die Dokumente werden in sinnvolle Abschnitte zerlegt, mit Quelle und Stand versehen und in eine Vektordatenbank geschrieben. Gute Schnitte entlang von Überschriften bringen mehr Qualität als jedes größere Sprachmodell.
Das Modell bekommt nur die gefundenen Abschnitte als Kontext und antwortet ausschließlich daraus. Jede Antwort nennt die Quelle, damit sie nachprüfbar bleibt. Findet die Suche nichts, sagt das System das – statt zu raten.
Die Fragenliste aus Schritt eins wird regelmäßig durchgespielt. Falsche Antworten sind fast immer ein Such- oder Datenproblem, kein Modellproblem – und genau dort wird nachgebessert.
5. Was realistisch herauskommt
Ein gut gebautes System beantwortet den Großteil der wiederkehrenden Fragen korrekt und mit Quellenangabe. Es ersetzt keine Fachabteilung, sondern nimmt ihr die immer gleichen Rückfragen ab. Die verbleibenden Fälle landen weiterhin bei einem Menschen – und das ist kein Mangel, sondern die richtige Arbeitsteilung.
Der zweite, oft unterschätzte Effekt: Die Einführung zwingt dazu, den Dokumentenbestand einmal ernsthaft aufzuräumen. Für den Arbeitsalltag ist dieser Nebeneffekt regelmäßig wertvoller als der Chatbot selbst.
Wissen Sie schon, welche Fragen Ihr System beantworten soll?
Dann ist der schwierigste Teil bereits erledigt. In einem kostenlosen Erstgespräch schauen wir uns Ihren Dokumentenbestand an und klären ehrlich, ob sich der Aufwand lohnt.
Mehr zum Leistungsumfang: KI & Wissensdatenbanken